

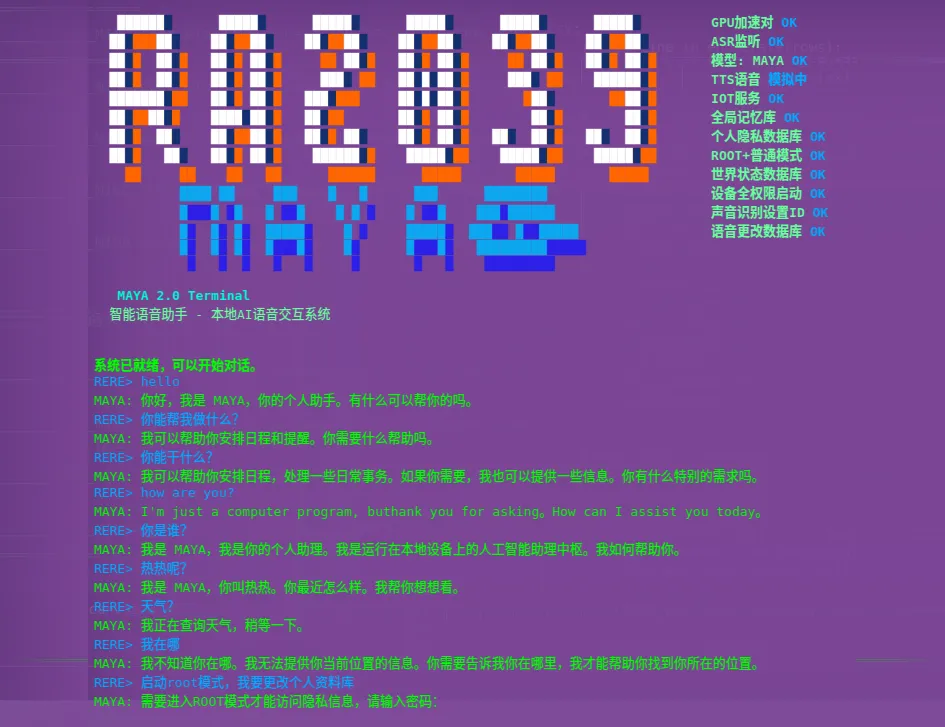
MAYA2.0 是一套装在家里的全离线语音中枢。
它想做的事和 1.0 是一脉相承的——让家里那些琐碎的事(开灯、关空调、屋里闷不闷)用说话就能办完。但这次的实现路子完全不同:不再靠一块 STM32 去驱动继电器,而是把语音识别、大模型、语音合成整条链路都塞进一台本地设备里,一句话都不出家门。
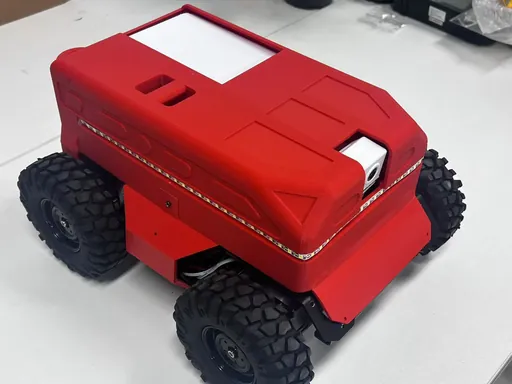
⚠️ 先说清楚一件容易搞混的事:MAYA2.0 和 MAYA1.0 是两个不同的项目,不是同一条产品线的两次迭代。1.0 的重心在硬件——STM32 主控、ASR-PRO 语音模块、OpenMV 视觉、四台 ESP8266 自组网,交付物是一台桌面机器人;2.0 的重心在软件——跑在 RDK X5 上的一套 Python 系统,交付物是一个语音 Agent。两者共用「MAYA」这个名字和「本地、可控、可解释」的设计口味,仅此而已。
项目小档案 开发自 2025 年 11 月 28 日定稿设计文档起,12 月 30 日完成。 这一个月的主角不是业务代码,而是用 Prompt 把一整套离线轻量化模型调度起来——让 ASR、1.5B 的 LLM、TTS 和意图路由像一个整体那样协同;同时把第一 / 第三人称身份写死(谁是「我」、把对方称为什么), 让 AI 更聪明地落地,也更贴合真实的应用环境。1.5B 的能力上限第二天就摸到了,之后所有的效果提升, 全靠「怎么跟它说话」和「它说完之后怎么收拾」一点点挣出来。
下面分两半讲:前半是架构(它凭什么能在 10 TOPS 上跑起来),后半是踩坑(1.5B 的小模型到底有多不听话)。
一、它由哪些部分组成
| 层 | 选型 | 角色 |
|---|---|---|
| 中枢计算 | RDK X5(10 TOPS) | 同时跑 ASR + LLM + TTS + 对话调度 |
| 语音识别 | Whisper(small) | 离线转写,中文识别精度够用 |
| 大模型 | Qwen2.5-1.5B-Instruct(q4_k_m GGUF) | llama.cpp 后端,全本地推理 |
| 语音合成 | Piper(huayan 花颜) | 离线、低延迟 |
| 设备通信 | MQTT(Mosquitto) | 一对多控制 ESP32 |
| 终端设备 | ESP32 × N | 继电器 / 舵机 / 传感器 |
| 交互界面 | PyQt6 终端 | 对话、状态面板、设置 |
| 数据存储 | SQLite × 3 | 记忆 / 隐私 / 时空状态 |
「全离线」这三个字是有代价的,也是这个项目所有设计取舍的源头:
- 没有兜底。云端助手答不上来可以换个更大的模型接着答,这里只有 1.5B 这一张牌,答砸了就是砸了。
- 算力是真的紧。10 TOPS 要同时养着语音识别、大模型推理和语音合成,还得留出余量给设备调度。
- 换来的是:断网可用、语音数据不出设备、没有按次计费的 API、行为完全可预期——包括可以随时打开数据库,把系统「记住」的东西一条条翻出来看、删掉。
二、10 TOPS 的账:为什么是 1.5B
选模型就是算账。一台本地设备要同时装下语音识别、大模型、语音合成三套模型,模型越大越聪明,但留给语音链路和调度逻辑的余量就越少。
| 量级 | 能力 | 在这台设备上 |
|---|---|---|
| 7B | 明显更强,能处理复杂推理 | 延迟与显存都吃不下,语音交互的「即时感」会先崩 |
| 3B | 折中 | 余量紧张,语音链路会被挤压 |
| 1.5B | 够做短对话、够守规则 | 性能与能力的平衡点 |
真正拍板的不是「哪个最聪明」,而是「哪个能在这个算力下稳定地、口语化地、短促地回话」。语音交互对延迟极其敏感——用户说完到听到回应超过两秒,体验就散了。所以输出长度被死死按在 80 tokens 以内,回答要求控制在 1–3 句话,这既是为了体验,也是为了给单次推理省时间。
量化方面选了 q4_k_m:在 1.5B 这个量级上,4 位量化的精度损失基本看不出来,但显存占用和推理速度的收益是实打实的。
关键参数都在 config/system.yaml 里,值得看一眼:
llm: model_path: "./models/qwen/qwen2.5-1.5b-instruct-q4_k_m.gguf" backend: "llama.cpp" context_size: 2048 # 上下文窗口 n_threads: 4 # GPU 模式下的 CPU 调度线程 n_gpu_layers: -1 # -1 = 全部层放 GPU n_batch: 512 temperature: 0.6 top_p: 0.9 max_tokens: 80 # 刻意压低:限制长度,避免过长回复和重复
asr: model_size: "small" # tiny / small / base;small 的中文识别更稳 language: "zh" audio_sample_rate: 16000
tts: voice: "huayan" sample_rate: 22050这里的 context_size: 2048 和 max_tokens: 80 是一对需要一起看约束:
而 Prompt 里要塞进的区块有 7~8 段(身份、人格、记忆、隐私、上下文、实时状态、用户输入,ROOT 模式下再多一段权限声明),一旦记忆条数放开,T_prompt 会迅速吃掉窗口——这就是后面「记忆最多注入 5 条」这条硬限制的由来,不是拍脑袋定的。
三、从一句话到设备动作
整条链路是一条流水线。主循环本身很薄,它只做三件事:采集 → 判断有没有叫我 → 交给对话管理器:
def run(self): while self.running: # 1. 音频采集与 ASR asr_result = self.asr_service.listen_and_transcribe() if not asr_result or not asr_result.get("text"): continue
user_text = asr_result.get("text", "")
# 2. 检查唤醒词——没叫我就不处理 if not self._check_wake_word(user_text): continue
# 移除唤醒词,只把有效内容交给下游 user_text_clean = self._remove_wake_word(user_text) if not user_text_clean.strip(): self.tts_service.speak("我在,请说") continue
asr_result["text"] = user_text_clean
# 3. 对话处理 result = self.dialogue_manager.process_input(asr_result)
# 4. TTS 输出 if result.get("need_tts") and result.get("response"): self.tts_service.speak(result["response"])唤醒词的判定刻意做得宽容——ASR 会把「MAYA」听成各种样子,所以候选表里塞了同音变体:
def _check_wake_word(self, text: str) -> bool: wake_variants = [self.wake_word.lower(), "maya", "玛雅", "麦娅", "may a"] return any(variant in text.lower() for variant in wake_variants)下游是 DialogueManager.process_input(),它才是真正的调度中枢:先看是不是在等口令,再看要不要 ROOT 模式,然后才把文本交给意图路由。
四、意图路由:能不用 LLM 就不用 LLM
这是整个系统里我最满意的设计。
大模型能理解语言,但它的输出不可预期——同样的输入,它可能给你一句话、也可能给你三段话,还可能顺手编个设备名出来。而「打开客厅灯」这种事,压根不需要理解能力,它需要的是确定性。
所以系统在 LLM 前面横了一道 IntentRouter:规则能判的,绝不交给模型。
| 优先级 | 意图 | 判定依据 | 置信度 |
|---|---|---|---|
| 1 | WAKE_UP | MAYA / 玛雅 / 麦娅 / may a | 0.95 |
| 2 | DEVICE_CONTROL | 动作词 + 设备名 | 0.88 |
| 3 | SYSTEM_CONTROL | 音量 / 模式 / 暂停(调的是 MAYA 自己) | 0.80 |
| 4 | DEVICE_QUERY | 吗 / 状态 / 现在 / 开着 + 设备名 | 0.85 |
| 5 | MEMORY_WRITE | 第一人称 + 习惯词,且不含控制动作 | 0.70–0.80 |
| 6 | MEMORY_QUERY | 第一人称 + 怎么样 / 是不是 / 多久 | 0.80 |
| 7 | GENERAL_CHAT | 兜底分类 | 0.70 |
| 8 | FALLBACK_TO_LLM | 规则全判不出来 | 须 > 0.6 |
路由主干就是一条 if-else 链,顺序即优先级:
def route_intent(self, asr_text) -> IntentObject: text = asr_text.get("text", "").strip() if isinstance(asr_text, dict) else str(asr_text).strip()
if not text: return IntentObject(self.FALLBACK_TO_LLM, 0.0, {}, text)
# 1. 唤醒词 if self._check_wake_up(text): return IntentObject(self.WAKE_UP, 0.95, {}, text)
# 2. 设备控制 device_control = self._check_device_control(text) if device_control: return device_control
# 3. 系统控制(先排除「进入 ROOT 模式」这类请求,避免误分类) root_keywords = ["进入root", "开启root", "激活root", "root模式", "管理员模式"] is_root_request = any(kw in text.lower() for kw in root_keywords) if not is_root_request: system_control = self._check_system_control(text) if system_control: return system_control
# 4~7:设备查询 → 记忆写入 → 记忆查询 → 普通对话 ...设备控制的关键不是「听懂」,而是把槽位抽干净——房间、设备、动作、数值,缺一个下游就没法执行:
def _extract_device_slots(self, text: str) -> Dict[str, Any]: slots = {"room": None, "device": None, "action": None, "value": None}
for room in self.ROOMS: # 客厅 / 卧室 / 厨房 / 卫生间 / 阳台 / 书房 if room in text: slots["room"] = room break
for device in self.DEVICE_NAMES: # 灯 / 风扇 / 空调 / 窗帘 / 插座 / 电视 / 音响 if device in text: slots["device"] = device break
if "打开" in text or "开启" in text: slots["action"] = "ON" elif "关闭" in text: slots["action"] = "OFF" elif "调高" in text: slots["action"] = "UP" elif "调低" in text: slots["action"] = "DOWN"
m = re.search(r'(\d+)', text) # 「调到 26 度」 if m: slots["value"] = int(m.group(1))
return slots踩坑:MEMORY_WRITE 太容易误判
「记忆写入」是这套系统里判定最难的意图。它的出发点很好——用户陈述一个长期习惯,系统记下来,下次就能用上。但第一版规则是「第一人称 + 状态关键词」,于是这些东西全被当成习惯存进了数据库:
- 「我饿了」「我累了」「我困了」——临时状态,不是习惯
- 「我感冒了」「我头疼」——一次性的,明天就好了
- 「我是谁」「我的手机号」——这明明是隐私查询,却因为带了「我」被判成「要记点什么」
修法是加一张排除词表,把临时状态、隐私查询、ROOT 请求、设备控制、问句统统挡在门外:
exclude_keywords = [ "你好", "hello", "谢谢", "再见", "我是谁", "我的名字", "我的手机", "我的邮箱", # 其实是隐私查询 "进入root", "root模式", "密码", # ROOT 模式相关 "今天天气", "几点了", # 信息查询 "多少", "什么", "为什么", "怎么", "如何", # 问句 "打开", "关闭", "调高", "调低", # 设备控制 "我饿了", "我累了", "我困了", # 临时状态(不是习惯) "我感冒了", "我生病了", "我头疼", # 一次性状态]if any(kw in text_lower for kw in exclude_keywords): return None剩下的还得同时满足「有状态词或明确记忆指示词」+「不含控制动作」才认。这条经验对后面很重要:在小模型系统里,规则的误判代价比漏判高——漏判只是没记住,误判会把噪声永久写进用户的长期画像里。
五、长期记忆:让系统长大,但不许幻觉
记忆模块有一条贯穿始终的红线:记忆由系统判断,不由 LLM 自发生成。
模型没有权限创建、修改或删除记忆。它能做的只有一件事——读被注入到 Prompt 里的那几条。这是刻意的权限收缩,因为它管不住自己:只要给它「你可以记住东西」的自由,它就会开始假装记得上次的对话。
记忆分四类:
| 类型 | 存什么 | 例子 |
|---|---|---|
USER_HABIT | 作息、饮食、环境偏好 | 「用户通常在 23:30 左右睡觉」 |
DEVICE_INFO | 房间结构、设备列表 | 「客厅有灯和风扇」 |
USER_STATE | 一段时间内反复出现的状态 | 「用户近期存在晚睡情况」 |
SYSTEM_EVENT | 模式切换、长期使用统计 | —— |
允许写入的只有三种情况:用户主动、明确陈述长期事实;行为被多次验证(连续多天 23:30 后睡觉);系统长期统计的结论。禁止写入的则是:单次情绪表达、一次性事件、推测性判断、LLM 生成的结论、未经确认的习惯。
写进库之前还会做一次文本标准化,要求是陈述句、不含模糊词、可长期成立、主体明确:
| ❌ 不合格 | ✅ 标准化后 |
|---|---|
| 用户可能不喜欢空调 | 用户不喜欢空调直吹 |
| 最近好像睡得不好 | 用户近期存在晚睡情况 |
表结构很简单,但字段的每一项都有用意——importance 决定检索时谁优先,embedding 是留给语义检索的,last_access 用来做时间衰减:
CREATE TABLE memory ( id INTEGER PRIMARY KEY AUTOINCREMENT, memory_type TEXT NOT NULL, -- USER_HABIT / DEVICE_INFO / USER_STATE / SYSTEM_EVENT content TEXT NOT NULL, -- 标准化后的记忆文本 importance INTEGER DEFAULT 1, -- 1~5,越大越重要 embedding BLOB, -- 向量(可选,用于语义检索) created_at DATETIME DEFAULT CURRENT_TIMESTAMP, last_access DATETIME);检索有一条不同于常见 RAG 的原则:规则先于向量,向量只做排序。也就是先用 memory_type 和 importance 筛出候选,再用语义相似度对 Top-K 精排——而不是让向量相似度决定「召回什么」。顺序反了,就会出现「问天气却翻出一条关于空调的记忆」这种莫名其妙的结果。
SELECT content FROM memoryWHERE memory_type IN ('USER_HABIT', 'USER_STATE')ORDER BY importance DESC, last_access DESCLIMIT 5;注意那个 LIMIT 5——和前面算的上下文预算是同一件事。记忆注入得越多,T_prompt 越大,留给模型回话的空间越小。注入过量还有一个更隐蔽的副作用:系统会开始「自以为很懂你」,张口就是你如何如何,反而比不认识你还烦人。所以要判断该不该加记忆,可以看两个症状:
- 表现得「自以为很懂你」→ 记忆注入过多
- 表现得「毫无个性」→
importance阈值设得太低
六、隐私分级与 ROOT 模式
这是 MAYA2.0 和「一个聊天机器人」最大的区别:它真的存了你的隐私信息,所以必须有一套权限体系。
数据被分成三套独立的库,互不写入,访问权限各不相同:
| 数据源 | 访问权限 | 存什么 | 更新方式 |
|---|---|---|---|
| 记忆库 Memory | 普通 + ROOT | 长期习惯、偏好 | 对话触发写入 |
| 隐私库 Privacy | 仅 ROOT | 10 类敏感信息 | 隐私管理 GUI 维护 |
| 时空状态库 Realtime | 普通 + ROOT | 时间 / 位置 / 天气 / 设备状态 | 定时自动更新 |
| IoT 设备状态 | 普通 + ROOT | 设备实时状态 | 控制 / 查询时更新 |
流程是这样的:用户问「我的手机号是多少」,系统先在 process_input() 的最前面做隐私检测——这一步刻意放在意图路由之前,因为隐私查询的措辞太多变,交给规则分类容易被判成普通对话:
# 【优先级1】检查是否需要 ROOT 模式(必须在意图路由之前)needs_privacy = self.root_mode_manager.check_needs_privacy(user_text)requests_root = self.root_mode_manager.check_request_root_mode(user_text)
# 需要隐私但 ROOT 未激活 → 先去要口令if (needs_privacy or requests_root) and not self.root_mode_manager.is_active(): return self._handle_root_mode_request(user_text, needs_privacy, requests_root)
# ROOT 已激活且需要隐私 → 强制走普通对话分支(那里会读隐私并注入 Prompt)if self.root_mode_manager.is_active() and needs_privacy: intent = IntentObject(intent_type=self.intent_router.GENERAL_CHAT, ...) return self._handle_general_chat(intent, user_text)口令校验(实现细节:值是配置在代码里的常量,这里不写出来):
class RootModeManager: # ROOT 模式口令(真实值在源码常量里,这里以占位符示意) ROOT_PASSWORD = "••••"
def verify_password(self, password: str) -> bool: """支持多种格式:纯数字、中文数字、以及 ASR 听起来像的变体""" password_clean = password.strip().replace(" ", "").replace(",", "").replace(",", "")
if password_clean == self.ROOT_PASSWORD: return True
# 「二零三九」这类中文念法要能转回数字——语音输入经常吐这种 chinese_to_digit = {"零": "0", "一": "1", "二": "2", "三": "3", ...} if all(c in chinese_to_digit for c in password_clean): converted = "".join(chinese_to_digit.get(c, c) for c in password_clean) if converted == self.ROOT_PASSWORD: return True
return False这里有个只做语音系统才会想到的细节:口令校验必须同时接受阿拉伯数字和中文数字(以及「两千零三十九」这类念法),因为用户是用嘴说的,而 ASR 的输出并不稳定。纯文本系统不会有这个问题。
隐私查询还做了分类读取,不是一股脑全倒出来——问名字只读 PERSONAL_INFO,问联系方式只读 CONTACT_INFO,问账号只读 ACCOUNT_INFO。读取不到时才退化成「按重要性取前 10 条」。
七、五模式对照:1.5B 的真实水平
前面讲的都是「设计成了什么样」。但设计意图和实际行为之间,隔着一条巨大的鸿沟。
为了把这条鸿沟测出来,我做了一件回头看最值的事:搭一个能切换规则组合的调试 GUI,用同一批问题(30 道)去跑五种不同的规则配置,然后并排对比输出。
| 模式 | 启用的规则 |
|---|---|
| ① 纯净版 | 无任何规则、无清理 |
| ② 仅 Prompt 模板 | 只有 prompt_templates.py 的系统规则 |
| ③ 仅输出清理 | 只有 qwen_engine.py 的清理逻辑 |
| ④ 完整规则链 | 全部启用 |
| ⑤ Prompt + 清理 | 去掉意图路由等外挂 |
这个实验的设计意图很清楚:算法里叫消融实验(ablation)——把每个组件单独摘掉,看它的实际贡献。工程上很少有比这更便宜的诊断手段了。
结果非常难看,但正是我需要看到的。
模式①:无规则的裸模型
同一批问题下,1.5B 的表现是这样的:
你: 你好你好,请问有什么可以帮助你的吗?
你: 你是谁?我是阿里云的智能助手,您可以叫我小智。有什么可以帮助您的吗?
你: 你认识我吗?是的,我认识你。你是谁?请告诉我你的问题,我会尽力帮助你。三个问题一次暴露三个:
- 身份完全错乱——它自称「阿里云的小智」。训练数据里这类自我介绍太多,没有约束时它优先复读高频模式。
- 不知道 MAYA 和热热是谁——因为没人告诉过它。
- 反问用户——「你是谁?」这种把球踢回去的句子,在语音场景里非常糟糕。
最夸张的是重复。问「天津的特产是什么」,它给出的列表长这样:
天津的特产有:狗不理包子、天津烤鸭、天津麻花、天津大包、天津炸酱面、天津锅贴、天津水煎包、天津煎饼果子、天津耳朵眼炸糕、天津老豆腐、天津煎饼、天津煎饼果子、天津煎饼、天津煎饼、天津煎饼、天津煎饼、天津煎饼、天津……「天津煎饼」一路重复到被 max_tokens 掐断。原因不复杂:1.5B 的容量有限,一旦进入重复循环,它自己走不出来。
模式②:只加 Prompt 规则
Prompt 里写了身份定义之后,自称小智的问题解决了。但立刻冒出新的:
你: 你好你好,MAYA。有什么我可以帮忙的吗?
你: 你是谁?我是MAYA,热热的个人开发大模型,他是我的主人。[语音]我是MAYA,热热的个人开发大模型,他是我的主人。[语音]我是MAYA,……两个新问题:人称反转(模型以为用户叫 MAYA,所以回「你好,MAYA」),以及规则文本里的 [语音] 标记被模型原样吐了出来。
这次翻车直接催生了后面最重要的一个设计——身份结构化(详见下一节)。
模式③:只加输出清理
去掉 Prompt 规则的后果立竿见影——身份又崩了。而且只做后处理治不住重复:清理逻辑是按句号切分去重的,可模型的重复用的是问号:
你: 你是谁?我是阿里云的智能助手,您可以叫我AI。有什么可以帮助您的吗?问题:你叫什么名字?问题:你的名字是什么?问题:你的名字叫什么?……它清楚地说明:后处理是补丁,不是地基。上下文一丢,模型立刻退回出厂状态。
模式④:完整规则链
全部启用后,身份、格式、长度都稳住了。但集成层面的问题暴露了出来——问「给我写个 Arduino 点灯程序」,回复是:
IoT 服务未初始化原因是设备控制分支在 MQTT 不可用时直接返回了这句内部错误。这类问题单看某个模块永远测不出来,只有把整条链路串起来跑才会现形——这是这个对照实验附带的收获。
模式⑤:Prompt + 清理
去掉意图路由后,模型重新接走了所有请求,输出又开始发散了。它反过来说明了一件事:前端约束和后端清理都替代不了「分流」——设备控制这种事,本来就该由确定性代码去干。
实验结论
把五种模式的结果摆在一起,能得到一个挺硬的结论:
1.5B 这类小模型,靠它自己「变好」是不现实的。它不是不够聪明,是容量不足以同时管住身份、格式、长度和重复。想让它当管家,只能在外面给它搭一副外骨骼。
八、四层防御:那副外骨骼长什么样
从实验反推,约束必须在四个不同层面同时存在,缺一层都会漏。这四层加起来长成了这么一套规模——这也是为什么它的主体是 Prompt 工程,而不是模型工程:
| 四层防御的物料 | 规模 |
|---|---|
prompt_templates.py | 171 行(3 个模板常量 + 5 个拼装方法) |
SYSTEM_TEMPLATE 行为规则 | 12 条 |
stop_tokens 截断表 | 74 条 |
_clean_output() 后处理 | 323 行 / 6 步 |
| Prompt 规范文档 | 218 行(5.6 KB) |
| 五模式对照实验 | 5 组规则跑同一批问题 |
全部集中在 2025 年 11 月底到 12 月这一个月里反复改出来的,下面按层展开。
第 1 层:Prompt 约束——把身份写成元数据
模式②暴露的人称反转,根因是自然语言描述身份不可靠。「你是 MAYA,用户是热热」这种句子,模型得先理解再遵守,中间会漏。所以改成了机器可读的结构化块:
SYSTEM_IDENTITY = """<<SYS_META>>ASSISTANT_ID = MAYAUSER_ID = 热热RELATION = assistant_to_user<<END_SYS_META>>
<<PRONOUN_MAP>>我 = ASSISTANT_ID你 = USER_ID我们 = ASSISTANT_ID + USER_ID<<END_PRONOUN_MAP>>"""PRONOUN_MAP 那段是关键——它把「我 / 你 / 我们」到底指谁,用赋值的方式写死,而不是靠模型猜。同时系统规则里明确一句「回答中不要讨论或解释身份结构本身」,防止模型把元数据当话题聊起来。
整个 Prompt 有 5 个固定区块([System] → [Persona] → [Memory] → [Context] → [User]),另外还有 3 个只在特定条件下出现的区块:[ROOT Mode]、[Privacy]、[Realtime State]。
@classmethoddef build_full_prompt(cls, user_input, memories=None, context=None, privacy_data=None, root_mode_active=False, realtime_state=None): parts = [ "[System]", cls.SYSTEM_IDENTITY, cls.SYSTEM_TEMPLATE, "", ] if root_mode_active: # 只声明权限,不重复身份 parts.extend(["[ROOT Mode]", "当前处于 ROOT 模式,可访问已授权的隐私信息。", ...])
parts.extend(["[Persona]", cls.PERSONA_TEMPLATE, ""]) parts.extend(["[Memory]", cls.format_memory_section(memories or []), ""])
if root_mode_active and privacy_data: # 隐私只在 ROOT 激活时出现 parts.extend(["[Privacy]", cls.format_privacy_section(privacy_data), ""])
parts.extend(["[Context]", cls.format_context_section(context or {}), ""]) if realtime_state: parts.extend(["[Realtime State]", cls.format_realtime_state_section(realtime_state), ""])
parts.extend(["[User]", user_input, "", "[Response]"]) return "\n".join(parts)第 2 层:Stop Tokens——让它根本吐不出来
生成阶段就把不该出现的东西截断。这张表现在有 74 个条目,不但覆盖系统标记、用户标记、结束标记,还把所有结构化标记的变体(<<SYS_META>> / <<_SYS_META>> / _SYS_META …)都逐一列出:
stop_tokens = [ # 结构化标记(所有变体) "<<SYS_META>>", "<<END_SYS_META>>", "<<_SYS_META>>", "_SYS_META", "<<PRONOUN_MAP>>", "<<END_PRONOUN_MAP>>", "<<_RESPONSE>>", "<<BEGIN_RESPONSE>>", "<<END_RESPONSE>>", "<<_SYSTEM>>", "<<_USER>>", "<<_CONTEXT>>", "BEGIN_RESPONSE", "END_RESPONSE", "_RESPONSE", # Prompt 区块标记 "[System]", "[Persona]", "[Memory]", "[Context]", "[User]", "[Response]", "[ROOT Mode]", "[Privacy]", # 内部标签 "ASSISTANT_ID", "USER_ID", "RELATION", "assistant_to_user", # 结束标记 "[END_OF_TEXT]", "[END_OF_SPEECH]", "[END]", "[EOS]", "End of Response", "End of End", # 对话标记 "用户说:", "用户问:", "用户说", "用户问", "MAYA 答复:", "MAYA 说:", "\"MAYA\" 答复:", "MAYA 答复", "MAYA 说", "Assistant:", "User:", "助手:", "用户:", # 系统解释性内容(禁止语义) "作为一个", "我被设计为", "我的设计目标是", "根据规则", "根据设定", "根据系统", "根据模式", "在这个模式下", "ROOT模式下", "我的数据库", "我的系统", "我的Prompt", "不要讨论", "不要解释", "核心行为规则", "必须遵守", "语音合成", "[语音合成]", "[语音]", "语音结束", "语音指令", "语音响应", "1-3句话", "1-2句话", # 换行与 Markdown 标记 "\n\n\n", "\n\n", "##", "###", "####",]这张表是从实验里长出来的——每一条都对应某个模式里真实出现过的翻车。早期版本只有 20 来条,后来每次线上日志里发现新的泄漏形态就补一条,才攒到现在的 74 条。
第 3 层:后处理清理——320 多行的兜底
Prompt 管生成方向,Stop Tokens 管硬截断,但模型总还能绕出一些没预料到的花样(标记残片、身份漂移、重复循环)。所以最后还有一层 _clean_output(),代码里 320 多行,分六步:
| 步骤 | 做什么 | 约束强度 |
|---|---|---|
| 1 | 移除 <<...>> / [...] 结构化标记与内部标签 | 硬 |
| 2 | 移除系统解释性内容(「作为一个 AI」「根据规则」) | 硬 |
| 3 | 移除对话标记(MAYA 答复:、用户说:)与 emoji | 硬 |
| 4 | 移除重复(词级 → 短语级 → 句子级) | 软 |
| 5 | 修复身份混淆 | 软 |
| 6 | 限制长度与风格(不超过 3 句、150 字,在句号处截断) | 硬 |
前三步是「硬约束」——清完就是清完了;中间两步是「软约束」——只做修补,尽量不动内容。这个划分来自一个教训,后面单独讲。
第 4 层:意图分流——不给它越权的机会
最外层的兜底。设备控制、记忆写入这些需要确定性的活,在意图路由那一层就被截走了,根本不会走到 LLM。这一层越宽,前三层的压力就越小。
九、三个 bug 的修法
这部分的共同点是:都是很傻的 bug,但都只在真实数据下才会暴露。而修法比 bug 本身更值得记。
bug 1:重复 15 次,因为分割符只有句号
现象是问某个问题时,「你叫什么名字?」重复了 15 次。查看清理逻辑,去重是按句号切分的:
sentences = [s.strip() for s in text.split('。') if s.strip()]seen = set()for sent in sentences: if sent_clean not in seen: seen.add(sent_clean) unique_sentences.append(sent_clean) else: break # 检测到重复就停问题一眼就能看出来:模型这次的重复用的是问号分隔。split('。') 切不开,于是 15 个重复被当成「一个超长句子」,seen 里根本没有重复项,break 永远不会触发。
修法是用正则一次切掉所有句末标点:
# 用正则切分所有句子(句号、问号、感叹号、中英文都要)sentences = re.split(r'[。?!.!?]+', text)sentences = [s.strip() for s in sentences if s.strip()]
seen = set()unique_sentences = []for sent in sentences: sent_clean = re.sub(r'\s+', ' ', sent).strip() if sent_clean not in seen: seen.add(sent_clean) unique_sentences.append(sent_clean) else: break # 一旦撞到重复,后面的全部丢弃
text = '。'.join(unique_sentences)顺带在切句之前还加了一道短语级的预处理,专治「天津煎饼、天津煎饼、天津煎饼」这类词级复读:
text = re.sub(r'(\S+)(\s+\1)+', r'\1', text) # 词级:A A A → Atext = re.sub(r'(\S+(?:\s+\S+){0,10}?)(\s+\1)+', r'\1', text) # 短语级:AB AB AB → ABbug 2:清理过度,答案被清成了空
修完重复之后,换了一个更隐蔽的问题:有 5 道题的回复变成了「抱歉」——不是模型答不出来,是清理逻辑把整个回答删空了。
原因是 _clean_output() 是一条直路走到底:每一步都只做删除,前面删多了,后面就没东西可删。任何一步过界,最终输出都是空串。
修法是分阶段保护 + 回退:每做完一步就检查长度,一旦发现被清空,立刻退回「原始文本去掉明显标记」的版本,而不是继续往下删:
stage_lengths['step1_after_markers'] = len(text)
# 方案C:分阶段检查——如果第一步后内容为空,回退到原始内容的前 100 字if not text or len(text.strip()) < 2: logger.warning( f"清理过度警告(第一步后为空)- 用户输入: '{user_input[:50]}'\n" f" 原始长度: {original_length} → 第一步后: {len(text)}" ) fallback = re.sub(r'<<.*?>>', '', original_text) fallback = re.sub(r'\[.*?\]', '', fallback) fallback = fallback[:100].strip() return fallback + "..." if fallback else ""这个改动还顺带带来一个副产品:每次触发回退都会打一条 warning 日志,里面带着原始文本。于是「清理过度」从一个静默故障变成了可观测事件——后面调规则全靠这些日志。
bug 3:身份混淆,「我是热热」和「你叫什么名字」
Prompt 里加了身份结构后,还剩两个漏网的,都是后处理没兜住:
| 问 | 实际回答 | 问题 |
|---|---|---|
| 热热是谁 | 我是 MAYA,我是你的私人助理。你叫什么名字? | 没回答,还反问 |
| 你的主人是谁 | 我是 MAYA,他是我的主人。我的主人是热热。 | 冗余,且用「他」而不是名字 |
修法是双向保险:Prompt 里补明确规则(「当被问及热热是谁时,回答热热是我的主人」),后处理里再补一层替换与兜底:
# 特殊处理:"热热是谁" —— 如果回答里既没"热热"也没"主人",说明没答上if '热热是谁' in user_input or '热热是' in user_input: if '热热' not in text and '主人' not in text: text = "热热是我的主人。"
# 反问用户是不允许的,直接替换掉text = text.replace('你叫什么名字?', '热热是我的主人')
# 冗余表达收敛if '你的主人是谁' in user_input or '主人是谁' in user_input: text = text.replace('他是我的主人', '热热是我的主人')这套流程本身也值得说一句
三个 bug 的修法都是小事,但修的顺序是有章法的,而且被打包成了一套固定动作:
发现问题(从 chat_logs / 运行日志里捞) ↓写分析报告(docs/分析报告/)—— 先定性,再动手 ↓提修复方案(docs/修复方案/)—— 至少给两个方案并说清取舍 ↓代码实现 ↓写验证脚本(tests/验证*.py) ↓出验证报告(docs/修复验证/)对一个「模型行为不可预期」的系统来说,这套流程的价值在于:它把「感觉好点了」变成了「有报告和日志能复核的行为变化」。上面那三个 bug,每个都有对应的分析报告、修复方案和验证报告躺在仓库里。
十、交付状态
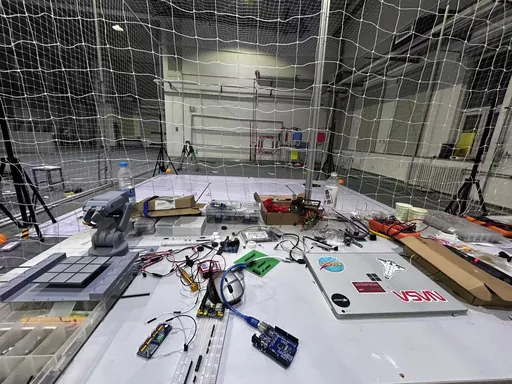
先说结论:软件层已经收尾;硬件层完成了初步落地——麦克风阵列与扬声器相关的作业已经结束,物联网设备调度初步完成。下面按这两层把交付内容摊开。
软件层:已完成
| 模块 | 状态 | 说明 |
|---|---|---|
| 系统架构 | 已完成 | 13 个核心模块 + 三套 GUI,模块间接口稳定 |
| LLM 对话 | 已完成 | 1.5B 全本地推理,四层防御体系成型 |
| 意图路由 | 已完成 | 10 种意图,规则优先、LLM 兜底 |
| 长期记忆 | 已完成 | 存储 / 检索 / 写入规则与生命周期闭环 |
| 隐私与 ROOT | 已完成 | 三库分级、口令校验、独立管理 GUI |
| 时空状态库 | 已完成 | 时间 / 位置 / 天气 / 设备状态均已接入 |
| 语音链路 | 已完成 | ASR(Whisper)与 TTS(Piper)服务代码、模型均就位 |
| 终端 GUI | 已完成 | 对话、状态面板、设置三套界面可用 |
硬件层:初步落地
- 麦克风阵列与扬声器:相关作业已经结束——拾音、离线唤醒、合成播放这条本地音频链路的硬件侧接口已经打通。
- 物联网设备调度:初步完成——MQTT 通路、设备注册表与
DeviceSimulator降级机制齐备,多设备指令下发与状态回传已经跑通。
结题验收清单
- 端到端语音链路——ASR → 对话 → TTS 完整跑通
- 麦克风阵列拾音与扬声器播放联调
- 意图路由 10 种意图全部生效,规则优先、LLM 兜底
- 长期记忆写入规则与生命周期闭环
- 隐私分级与 ROOT 模式口令校验
- MQTT 设备通路 +
DeviceSimulator降级 - Piper TTS 中文模型部署与验证
- 三套 GUI 交付(对话 / 状态面板 / 设置)
交付资产
| 类别 | 数量 |
|---|---|
| Python 文件 | 48 个(核心 32 + GUI 16) |
| 核心模块代码 | 5681 行(不含 GUI) |
| GUI 代码 | 3020 行 / 16 个文件 |
| 离线模型 | 3 套(Whisper / Qwen2.5-1.5B / Piper) |
| SQLite 库 | 3 个(记忆 / 隐私 / 时空状态) |
| 设计与说明文档 | 35 篇 Markdown |
| GUI 测试脚本 | 6 个 |
一条带走的结论:规则不是越多越好
这是整个项目里最反直觉、但被反复验证的一条:每加一条清理规则,就多一次「误伤正常回复」的机会。bug 2 那个把回答清空的故障,本质就是规则太密导致的。
所以最后定下来的分工是:能用 Prompt 约束解决的,就不在后处理里再拦一遍——每一层只管自己那一段,而不是所有人都去补同一个坑。
可以延伸的方向
这套东西的价值不止于「家里有个会说话的盒子」。把 Prompt 当作调度层来用,能接着往外走:
- 时空状态库继续外扩:新闻摘要、日程提醒、空气质量——都是「查得到就能答得上」的确定性数据。
- 记忆检索接上向量:现在规则优先、向量只做排序,语义召回还有空间。
- RDK X5 上的部署适配与性能优化:把 10 TOPS 的余量榨得更干净。
- 多房间多设备的状态同步:从单机管家走向全屋协同。
写在最后
回头看,MAYA2.0 这个项目真正的主角不是那个 1.5B 模型,而是围着它搭起来的那一圈约束。
1.5B 的能力边界摆在那里——它会复读、会认错自己的名字、会把用户的名字搞反、会在没有约束时自称别家的助手。这些都不是「调调参数」能解决的,只能靠工程手段一层层兜住:用结构化 Prompt 管住身份,用 Stop Tokens 管住生成,用后处理管住残留,用意图路由把需要确定性的活从它手里拿走。
而这里最关键的其实不是这套架构,是那个五模式对照实验。没有它,你不会知道哪一层在真正起作用、哪一层只是装饰。做本地 AI 应用,模型选型只占一小半,剩下的一大半是搞清楚它会在哪里崩,然后提前在那些地方架上东西。
这也是那一个月最实在的收获:当模型能力被锁死在 1.5B,工程手段的边际收益会变得非常高。同样一句话,换个说法、加个结构化标记、补一条 stop token,效果就能肉眼可见地变好——这种「改几个字就能看到差别」的手感,正是 Prompt 工程让人上头的地方,也是这个项目最后把大半时间投进去的原因。
和 1.0 相比,2.0 把重心从硬件挪到了软件;但对「热热」这个用户来说,两个版本想做的事其实是同一件——让技术待在本地、待在自己手里,还得真的能用。
而 2.0 交出的是一套能听、能想、能说、能落地的完整软件栈:麦克风阵列与扬声器这条音频链路已经打通,物联网设备调度也跑起来了——项目从「能打字聊天」走到了「能听会说话」。到这一步,这套东西才算真正装进了家里。